Você abre um documento em PDF, pressiona Ctrl + F, digita uma palavra que claramente aparece na página e recebe a mensagem de que nenhum resultado foi encontrado.
Depois tenta selecionar uma frase com o mouse, mas percebe que a página inteira se comporta como uma imagem.
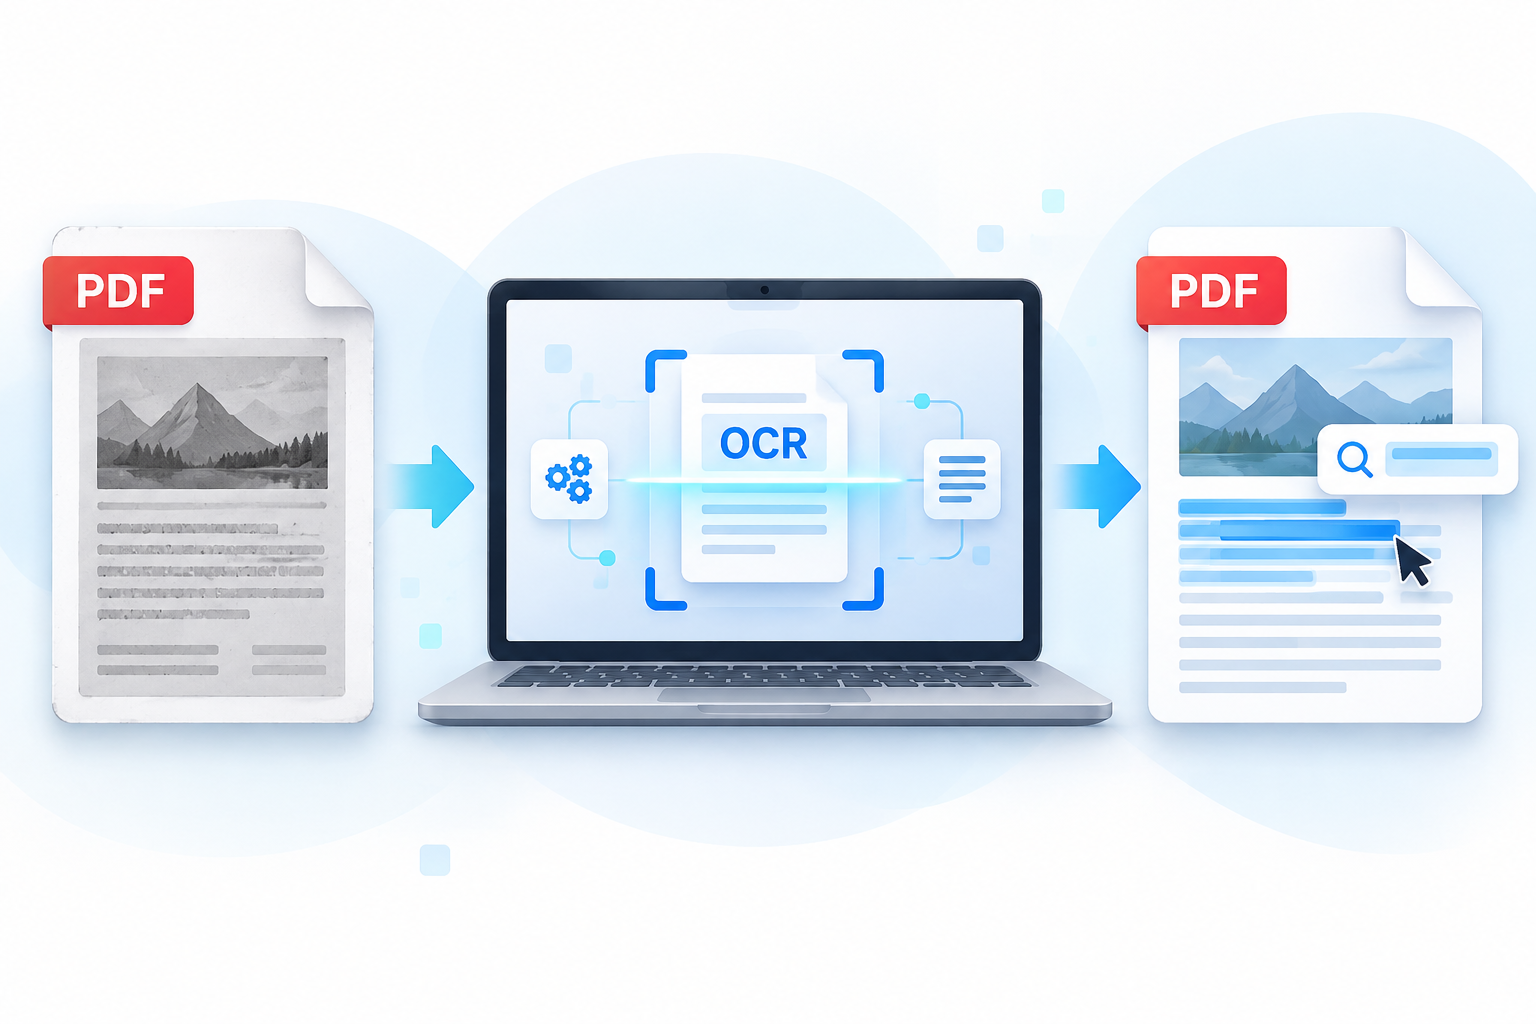
Esse problema é comum em PDFs digitalizados. Embora o documento mostre letras, números e parágrafos perfeitamente legíveis para uma pessoa, o computador pode enxergar apenas pixels.
Uma das maneiras de resolver isso é utilizar OCR, ou Reconhecimento Óptico de Caracteres.
Com essa tecnologia, o texto presente nas páginas pode ser reconhecido e transformado em informação digital, permitindo criar um PDF pesquisável no qual palavras e frases podem ser localizadas com mais facilidade.
Neste guia, você vai entender como tornar um PDF pesquisável usando OCR, quando esse processo é necessário, como verificar se funcionou e quais cuidados ajudam a obter resultados mais precisos.
O Que Significa Tornar um PDF Pesquisável?
Tornar um PDF pesquisável significa permitir que programas capazes de abrir o arquivo reconheçam as palavras existentes nas páginas.
Depois disso, você pode, dependendo da estrutura do documento e do programa utilizado, pesquisar palavras, selecionar trechos e copiar parte do conteúdo.
Isso é especialmente importante em PDFs criados por meio da digitalização de documentos físicos.
Imagine que você escaneie dez páginas de um contrato antigo.
O scanner pode criar dez imagens de ótima qualidade e agrupá-las dentro de um arquivo PDF. O documento parece normal quando aberto, mas as palavras continuam fazendo parte das imagens.
Pesquisar “pagamento”, por exemplo, pode não encontrar nenhuma ocorrência.
Quando OCR é aplicado, o sistema analisa essas imagens e tenta reconhecer os caracteres presentes nelas.
O resultado pode ser um documento visualmente semelhante ao original, mas com uma camada textual associada às páginas.
Por Que Alguns PDFs Não Permitem Pesquisar Texto?
O formato PDF pode armazenar diferentes tipos de conteúdo.
Um documento criado diretamente no Word, Google Docs ou outro editor normalmente já contém texto digital. Quando ele é exportado para PDF, essas informações continuam disponíveis para pesquisa.
Um documento escaneado funciona de maneira diferente.
Nesse caso, a página pode ter sido armazenada essencialmente como uma fotografia.
Você vê:
nomes, datas, valores, títulos e parágrafos.
O computador, porém, pode enxergar apenas uma imagem.
Por isso, o fato de você conseguir ler um documento não significa automaticamente que o software consiga interpretar seu texto.
O Que É OCR e Por Que Ele É Necessário?
OCR significa Optical Character Recognition, ou Reconhecimento Óptico de Caracteres.
É a tecnologia utilizada para identificar caracteres presentes visualmente em imagens e convertê-los em informações textuais.
Durante o processamento de um PDF digitalizado, o OCR analisa as páginas, localiza regiões que parecem conter texto e tenta determinar quais letras, números e símbolos estão presentes.
Em seguida, a solução utilizada pode associar esse conteúdo reconhecido ao documento.
É essa etapa que permite transformar muitos PDFs baseados em imagem em arquivos pesquisáveis.
Segundo a documentação atual do Adobe Acrobat, documentos escaneados podem conter somente dados de imagem. Ao executar OCR, o programa pode criar uma camada de texto pesquisável no PDF.
Como Saber se Seu PDF Precisa de OCR?
Antes de processar o arquivo, vale a pena descobrir se ele realmente precisa de reconhecimento óptico de caracteres.
Abra o documento e tente selecionar apenas uma palavra.
Se você conseguir marcar letras individualmente, existe uma boa chance de que aquela parte do arquivo já contenha texto digital.
Depois, pressione Ctrl + F no Windows ou Command + F no macOS e pesquise uma palavra que você consegue ver claramente na página.
Se a pesquisa localizar a palavra corretamente, o PDF provavelmente já possui conteúdo pesquisável naquela região.
Caso você não consiga selecionar palavras e a pesquisa não retorne resultados, mesmo para termos claramente visíveis, o arquivo pode ser formado por imagens e se beneficiar do OCR.
É importante testar mais de uma página porque alguns documentos são mistos: determinadas páginas possuem texto digital, enquanto outras foram adicionadas como imagens digitalizadas.
Como Tornar um PDF Pesquisável Usando OCR
O funcionamento exato varia de acordo com o programa ou serviço utilizado, mas o processo geral é bastante semelhante.
1. Abra o PDF digitalizado
Comece selecionando o documento que deseja tornar pesquisável.
Antes de realizar qualquer alteração importante, especialmente em documentos únicos ou difíceis de substituir, é recomendável manter uma cópia do arquivo original.
Isso permite retornar à versão anterior caso o processamento produza algum resultado inesperado.
A Adobe também recomenda manter uma cópia do PDF digitalizado original antes de realizar alterações relacionadas ao reconhecimento de texto.
2. Escolha uma ferramenta com OCR para PDF
Você precisa de uma ferramenta capaz de reconhecer o texto existente nas páginas do documento.
Existem soluções instaladas no computador e serviços que funcionam diretamente no navegador.
O ponto mais importante é verificar o resultado que a ferramenta oferece.
Algumas soluções apenas extraem o texto do documento.
Outras aplicam OCR e salvam um novo PDF pesquisável, mantendo as páginas originais e adicionando informações textuais reconhecidas.
Se o seu objetivo é continuar utilizando o documento como PDF e pesquisar diretamente dentro dele, procure especificamente uma função de OCR para PDF pesquisável.
3. Envie ou importe o documento
Depois de abrir a ferramenta escolhida, importe o arquivo.
Dependendo do programa, você poderá selecionar todo o documento ou somente algumas páginas.
Isso pode ser útil em PDFs grandes nos quais apenas determinadas páginas foram escaneadas.
Se estiver utilizando um serviço online, considere também o tipo de informação contida no documento antes de fazer upload.
Arquivos contendo informações pessoais, financeiras, empresariais ou confidenciais merecem atenção especial às políticas de privacidade, armazenamento e exclusão oferecidas pelo serviço escolhido.
4. Escolha o idioma correto
Algumas ferramentas de OCR permitem informar o idioma predominante no documento.
Quando essa opção estiver disponível, escolha o idioma correspondente ao conteúdo.
Por exemplo, para um documento predominantemente em português, selecionar português pode ajudar o sistema a interpretar melhor acentos e padrões linguísticos.
Documentos que misturam vários idiomas podem exigir configurações diferentes, dependendo da ferramenta.
5. Inicie o reconhecimento OCR
Depois das configurações, execute o reconhecimento.
Nesse momento, a ferramenta analisa visualmente as páginas do PDF e tenta identificar caracteres, palavras e linhas.
O tempo necessário depende de fatores como tamanho do arquivo, quantidade de páginas, resolução das imagens e complexidade do documento.
Um PDF de uma única página tende a exigir menos processamento do que um arquivo contendo centenas de páginas digitalizadas.
6. Salve o PDF pesquisável
Quando o OCR terminar, salve o documento processado.
Dependendo da solução escolhida, a aparência da página pode permanecer praticamente idêntica à digitalização original.
A diferença está na presença do texto reconhecido.
Em algumas soluções, a imagem permanece visível e uma camada textual pesquisável fica associada ao documento.
Isso permite preservar a aparência da página original enquanto oferece recursos de pesquisa.
7. Teste o resultado
Não considere o processo concluído apenas porque a ferramenta informou que o OCR terminou.
Abra o novo arquivo e faça alguns testes.
Tente selecionar diferentes palavras e pesquise termos utilizando Ctrl + F ou Command + F.
Escolha palavras localizadas em diferentes páginas.
Também é útil copiar uma frase e colá-la temporariamente em um editor de texto. Assim, você consegue verificar se os caracteres foram reconhecidos corretamente.
Como Tornar um PDF Pesquisável no Adobe Acrobat
O Adobe Acrobat é um exemplo conhecido de programa que oferece reconhecimento OCR para documentos escaneados.
Na interface atual documentada pela Adobe, o processo envolve abrir o PDF digitalizado, acessar All tools > Scan & OCR, escolher In this file, definir páginas e idioma quando necessário e selecionar Recognize Text. O Acrobat então cria uma camada pesquisável no documento.
Os nomes exatos dos menus podem mudar conforme idioma, versão ou atualização do aplicativo, mas o princípio permanece o mesmo: selecionar o documento, executar o reconhecimento e salvar o resultado.
A Adobe também oferece uma opção de OCR pela web que reconhece o texto de PDFs enviados ao serviço.
O Acrobat é apenas um exemplo. O mesmo conceito pode ser encontrado em diferentes ferramentas de OCR.
É Possível Tornar um PDF Pesquisável Online?
Sim.
Existem ferramentas online capazes de processar PDFs com OCR diretamente pelo navegador.
Normalmente, você seleciona o documento, envia o arquivo, aguarda o reconhecimento e recebe uma versão processada.
Essa abordagem pode ser conveniente quando você não quer instalar um programa.
Entretanto, antes de enviar qualquer documento a um serviço online, verifique como o provedor trata os arquivos.
Isso é particularmente importante para contratos, documentos de identificação, informações financeiras, registros médicos ou materiais empresariais confidenciais.
Para documentos sensíveis, uma solução local ou aprovada pela organização responsável pelos dados pode ser mais apropriada.
PDF Pesquisável e Texto Extraído Não São a Mesma Coisa
Essa diferença é importante.
Imagine um PDF digitalizado contendo uma página de livro.
Você pode querer duas coisas diferentes.
A primeira é manter o documento em PDF e conseguir pesquisar palavras dentro dele.
Nesse caso, você precisa de uma solução que aplique OCR e gere ou salve um PDF pesquisável.
A segunda possibilidade é simplesmente obter as palavras da página para utilizar em outro lugar.
Nesse caso, você precisa extrair o texto.
O TransformarImagemEmTexto.com aceita PDFs entre os formatos compatíveis e pode utilizar OCR para extrair o conteúdo textual de páginas digitalizadas compatíveis.
Nesse fluxo, o objetivo é obter o texto reconhecido para que você possa revisá-lo, copiá-lo ou utilizá-lo em outro documento.
Isso não deve ser confundido com salvar uma nova camada pesquisável dentro do PDF original.
Como Extrair Texto de um PDF Digitalizado
Se você não precisa manter o PDF pesquisável e quer apenas recuperar seu conteúdo, o processo pode ser mais direto.
Acesse [Transformar Imagem em Texto — link para a ferramenta principal], selecione o arquivo PDF compatível e inicie o reconhecimento.
Depois do processamento, revise o texto extraído antes de copiá-lo ou utilizá-lo.
A ferramenta atual do site informa suporte a PDF, além de formatos como JPG, PNG, WEBP, HEIC, BMP, TIFF e GIF.
Essa alternativa pode ser útil quando você deseja recuperar rapidamente um parágrafo, uma anotação, informações de uma página ou conteúdo que será utilizado fora do PDF.
Como Melhorar a Precisão do OCR em PDFs
A qualidade do documento original influencia diretamente o reconhecimento.
Um sistema OCR terá mais facilidade com uma página nítida, alinhada e com bom contraste do que com uma digitalização borrada ou muito escura.
Se o documento físico ainda estiver disponível, procure produzir uma digitalização clara.
Evite páginas inclinadas, sombras, reflexos e cortes sobre as palavras.
Textos muito pequenos também podem ser mais difíceis de interpretar.
Quando o PDF já existe e apresenta baixa qualidade, algumas ferramentas oferecem funções de melhoria da imagem antes do OCR. No Acrobat, por exemplo, existem recursos para aprimorar documentos digitalizados e aplicar reconhecimento de texto.
Mesmo depois de melhorar o documento, ainda é importante revisar o resultado.
Por Que o OCR Pode Reconhecer Algumas Palavras Incorretamente?
OCR interpreta padrões visuais.
Quando dois caracteres possuem formas parecidas, podem ocorrer erros.
O número 0, por exemplo, pode ser confundido com a letra O.
Dependendo da fonte e da qualidade da digitalização, 1, I e l também podem ser difíceis de diferenciar.
Problemas adicionais podem surgir em páginas com manchas, texto apagado, fontes decorativas, colunas complexas ou baixa resolução.
Por isso, o objetivo não deve ser apenas “executar OCR”, mas também verificar o texto reconhecido.
A documentação do Acrobat recomenda revisar o documento depois do processamento e corrigir possíveis erros de reconhecimento.
Como Verificar se o OCR Funcionou Corretamente
Depois de salvar o documento, abra-o novamente.
Escolha uma palavra incomum que apareça em uma das páginas e faça uma busca.
Depois procure outro termo localizado em uma página diferente.
Também tente selecionar algumas frases.
Se as palavras puderem ser selecionadas individualmente e a pesquisa encontrar os termos corretos, o reconhecimento provavelmente está funcionando.
Ainda assim, isso não comprova que todos os caracteres foram reconhecidos perfeitamente.
Datas, valores, códigos, nomes próprios e números devem receber atenção especial.
Se o arquivo será utilizado para alguma finalidade importante, compare as informações reconhecidas com o documento original.
Por Que Ainda Não Consigo Pesquisar Meu PDF Depois do OCR?
Existem diferentes explicações possíveis.
A página pode ter qualidade insuficiente para reconhecimento confiável. O idioma configurado na ferramenta pode estar incorreto. Algumas páginas podem estar muito inclinadas ou conter fontes difíceis de interpretar.
Também é possível que a ferramenta utilizada tenha extraído o conteúdo, mas não tenha criado uma camada pesquisável dentro do próprio PDF.
Esse último caso é especialmente importante.
Uma ferramenta pode mostrar todo o texto corretamente após o processamento e ainda assim não devolver um PDF pesquisável.
Por isso, antes de escolher uma solução, verifique se ela oferece especificamente criação de PDF pesquisável ou apenas extração de texto.
É Possível Aplicar OCR Somente em Algumas Páginas?
Depende da ferramenta utilizada, mas diversas soluções permitem escolher um intervalo de páginas.
Isso é útil em documentos mistos.
Imagine um PDF de 50 páginas no qual as primeiras 40 foram geradas digitalmente, enquanto as últimas 10 vieram de um scanner.
Nesse cenário, talvez não seja necessário executar OCR em todo o documento.
No Acrobat, por exemplo, a ferramenta de reconhecimento permite definir o intervalo de páginas que será processado.
OCR Torna o PDF Editável?
Não necessariamente.
Pesquisável e editável são características diferentes.
Tornar um PDF pesquisável significa permitir que o software reconheça e localize seu conteúdo textual.
A possibilidade de modificar livremente as palavras depende da estrutura do documento e da ferramenta utilizada.
Alguns programas conseguem utilizar OCR para tornar documentos digitalizados tanto pesquisáveis quanto editáveis. Outros geram apenas uma camada para pesquisa e seleção.
Portanto, se seu objetivo é alterar o conteúdo original, verifique se a ferramenta escolhida também oferece edição de PDF.
OCR Altera a Aparência do Documento?
Nem sempre.
Muitos métodos mantêm a imagem digitalizada visível e adicionam uma camada textual associada a ela.
Nesse cenário, o documento continua visualmente parecido com o original.
Outras ferramentas podem reconstruir partes da página ou produzir um documento com estrutura diferente.
Por isso, sempre verifique o resultado antes de substituir o arquivo original.
Quando preservar fielmente a aparência do documento for importante, mantenha uma cópia da digitalização original.
Quais Documentos Podem se Beneficiar de um PDF Pesquisável?
O recurso pode ser particularmente útil em arquivos com grande quantidade de informação.
Um contrato extenso pode se tornar muito mais fácil de consultar quando você consegue pesquisar termos específicos.
O mesmo vale para livros digitalizados, relatórios antigos, apostilas, trabalhos acadêmicos, documentos empresariais, manuais, formulários e arquivos administrativos.
Em uma coleção de centenas de documentos, a capacidade de localizar rapidamente determinadas palavras pode reduzir bastante o trabalho de abrir página por página.
Vale a Pena Aplicar OCR em Todos os PDFs?
Não.
Se o documento já foi criado digitalmente e permite pesquisar, selecionar e copiar texto normalmente, executar OCR novamente geralmente é desnecessário.
OCR faz mais sentido quando existe conteúdo visual que ainda não foi reconhecido como texto.
Por isso, sempre faça o teste de seleção e pesquisa antes.
Além de evitar processamento desnecessário, isso ajuda a preservar a versão original de arquivos que já funcionam corretamente.
Cuidados ao Usar OCR em Documentos Importantes
O reconhecimento automático deve ser tratado como uma ajuda, não como garantia absoluta de precisão.
Se você estiver processando um documento jurídico, financeiro, acadêmico ou administrativo, revise cuidadosamente as informações importantes.
Um único número reconhecido incorretamente pode mudar um valor, uma data ou uma referência.
Também tenha cuidado com privacidade.
Antes de enviar documentos confidenciais para qualquer ferramenta online, leia as informações fornecidas pelo serviço sobre processamento, armazenamento e exclusão dos arquivos.
Quando existir uma política interna da empresa ou organização sobre documentos sensíveis, siga essa política.
Perguntas Frequentes Sobre Como Tornar um PDF Pesquisável
Como tornar um PDF pesquisável?
Você pode utilizar uma ferramenta de OCR que reconheça o texto presente nas páginas digitalizadas e salve uma camada textual no PDF. Depois do processamento, teste o documento pesquisando palavras com Ctrl + F ou Command + F.
O que é OCR em PDF?
OCR em PDF é a aplicação de Reconhecimento Óptico de Caracteres às páginas do documento. A tecnologia identifica letras e números presentes visualmente e os converte em informações textuais.
Como saber se um PDF já é pesquisável?
Tente selecionar uma palavra e use a busca do leitor de PDF. Se você consegue localizar palavras que aparecem no documento, provavelmente já existe texto pesquisável naquela página.
Por que não consigo usar Ctrl + F no meu PDF?
Uma das razões mais comuns é o documento ser formado por imagens digitalizadas sem uma camada textual. Nessa situação, pode ser necessário aplicar OCR.
É possível tornar um PDF escaneado pesquisável?
Sim. Esse é justamente um dos principais usos do OCR. A tecnologia pode reconhecer o texto das páginas escaneadas e permitir que uma ferramenta compatível crie uma camada pesquisável.
Posso tornar um PDF pesquisável online?
Sim. Existem serviços online com OCR para PDF. Antes de enviar documentos sensíveis, verifique as práticas de privacidade e tratamento de arquivos do serviço escolhido.
PDF pesquisável é o mesmo que PDF editável?
Não. Um PDF pesquisável permite localizar seu texto. Isso não significa necessariamente que todas as palavras possam ser alteradas. A edição depende da ferramenta e da estrutura do arquivo.
OCR funciona em português?
Muitas ferramentas modernas oferecem reconhecimento para português. Quando houver uma opção de idioma, escolher o idioma correto pode ajudar no reconhecimento de palavras e caracteres acentuados.
OCR é 100% preciso?
Não. A precisão depende da qualidade do documento, resolução, contraste, fontes, alinhamento e tecnologia utilizada. Informações importantes devem sempre ser revisadas.
Conclusão
Tornar um PDF pesquisável é especialmente útil quando o documento foi criado a partir de páginas digitalizadas que o computador interpreta apenas como imagens.
O OCR resolve esse problema analisando os caracteres visíveis e convertendo-os em informação textual.
Com uma ferramenta adequada, essa informação pode ser adicionada ao documento como uma camada pesquisável, permitindo encontrar palavras, selecionar trechos e trabalhar com o arquivo de maneira muito mais eficiente.
O processo, porém, não termina no reconhecimento.
É importante verificar a qualidade da digitalização, escolher corretamente as configurações disponíveis e revisar o resultado, principalmente quando o documento contém informações importantes.