Você provavelmente já encontrou uma informação importante dentro de uma foto, captura de tela ou documento digitalizado e percebeu que não conseguia selecionar ou copiar as palavras. Para uma pessoa, o texto está claramente visível. Para o computador, porém, aquele arquivo pode ser apenas uma coleção de pixels.
É justamente esse problema que o OCR ajuda a resolver.
OCR é a tecnologia usada para identificar letras, números, palavras e outros caracteres presentes em imagens e convertê-los em texto digital que pode ser pesquisado, copiado, editado e reutilizado.
É o que permite, por exemplo, transformar imagem em texto [link interno para a ferramenta principal] sem precisar digitar manualmente todo o conteúdo de uma fotografia ou documento escaneado.
Neste artigo, você vai entender o que significa OCR, como o reconhecimento óptico de caracteres funciona, quais são suas principais aplicações e quais fatores podem influenciar a qualidade do texto reconhecido.
O Que É OCR?
OCR é a sigla de Optical Character Recognition, expressão em inglês para Reconhecimento Óptico de Caracteres.
Trata-se de uma tecnologia capaz de analisar conteúdo visual e identificar caracteres escritos dentro de fotografias, documentos escaneados, capturas de tela e outros arquivos de imagem.
Imagine que você fotografe uma página impressa.
Visualmente, consegue ler todos os parágrafos. Entretanto, se tentar selecionar uma frase diretamente na fotografia, normalmente não será possível, porque as palavras fazem parte dos pixels da imagem.
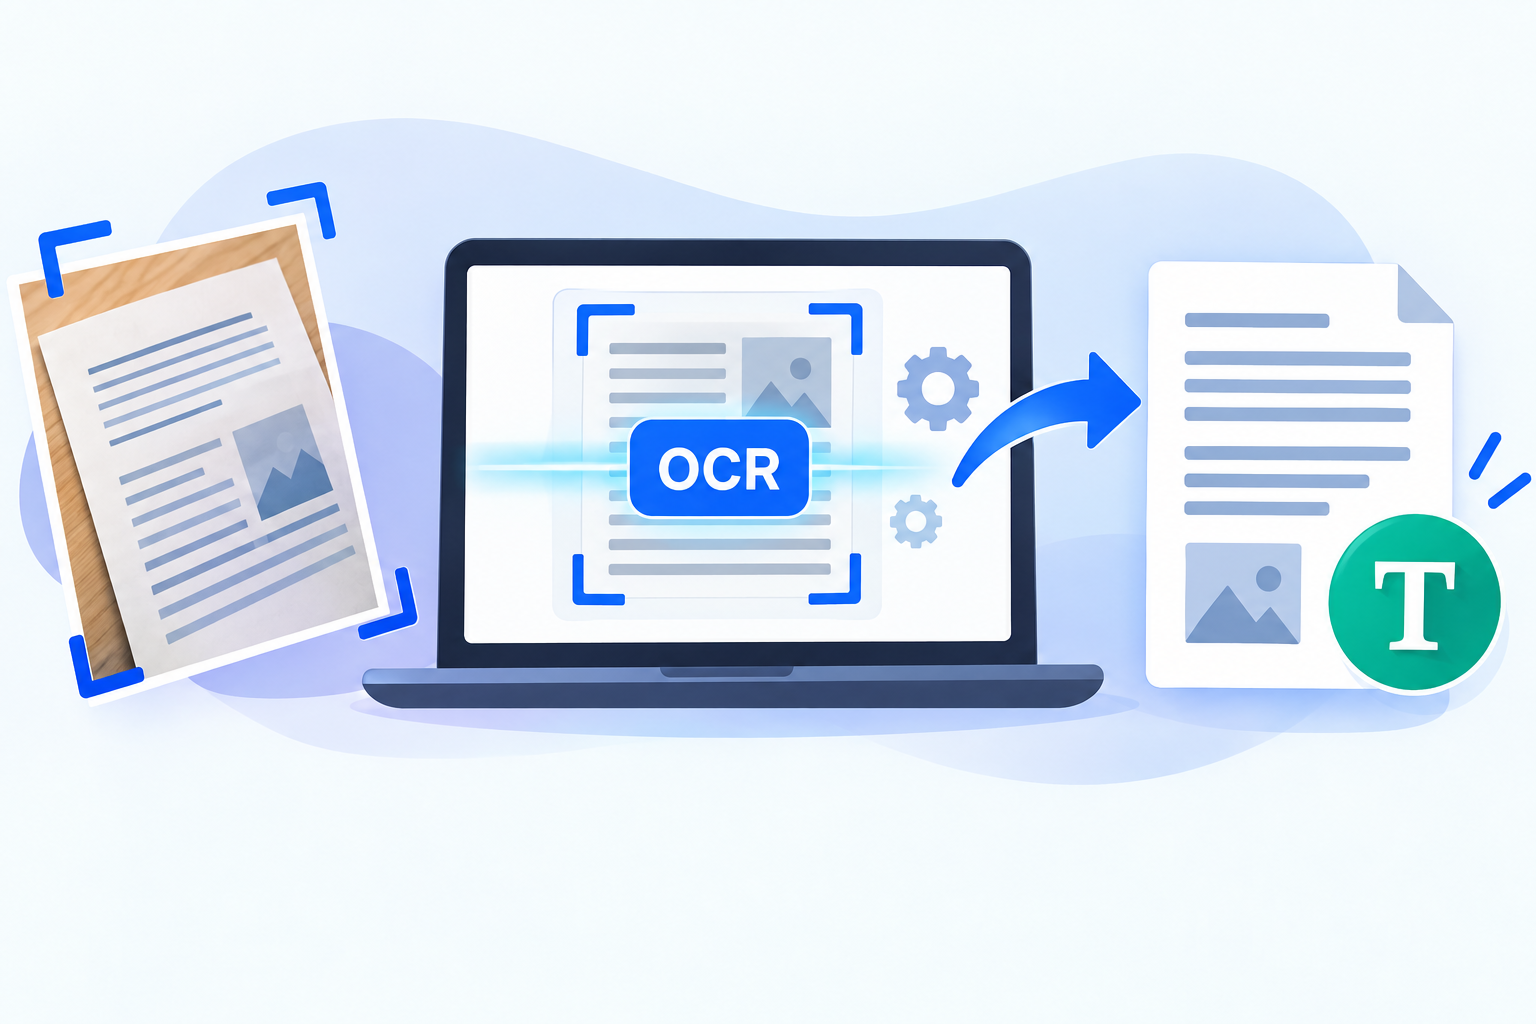
O OCR analisa esses pixels, procura regiões que parecem conter texto, reconhece os caracteres e cria uma representação digital das palavras encontradas.
Depois desse processo, uma frase que existia apenas visualmente pode se tornar texto selecionável.
Isso permite copiar uma informação para um documento, pesquisar palavras específicas, organizar arquivos digitalizados ou reaproveitar dados sem precisar transcrevê-los manualmente.
Para Que Serve o OCR?
A principal função do OCR é transformar informações visuais em dados textuais que possam ser utilizados por computadores e pessoas.
Um documento de papel digitalizado, por exemplo, pode gerar um arquivo que visualmente parece perfeito, mas cujo conteúdo não pode ser pesquisado. Aplicar OCR adiciona uma representação digital ao texto daquela página.
O mesmo princípio pode ser usado em fotografias, recibos, formulários, prints, livros, documentos administrativos e diversos outros materiais.
No cotidiano, isso significa que uma pessoa pode fotografar um texto e reaproveitar as informações sem ter que digitá-las novamente.
Em ambientes profissionais, o OCR também pode fazer parte de processos maiores de digitalização, arquivamento e organização de documentos.
Como Funciona o OCR?
Embora para o usuário o processo possa parecer simples, o reconhecimento de texto envolve diferentes etapas.
Um sistema moderno não procura apenas uma sequência de letras. Primeiro precisa entender onde existe texto dentro da imagem e depois tentar determinar quais caracteres correspondem aos padrões encontrados.
1. A imagem é recebida pelo sistema
O processo começa com uma imagem ou documento contendo algum tipo de conteúdo escrito.
Pode ser uma fotografia feita pelo celular, uma captura de tela, um documento escaneado ou uma página armazenada como imagem dentro de um PDF.
Nesse estágio, o sistema ainda está trabalhando com informação visual.
2. A imagem pode passar por pré-processamento
Antes de reconhecer as palavras, sistemas de OCR podem preparar a imagem para facilitar a leitura.
Dependendo da tecnologia utilizada, isso pode envolver ajustes relacionados a contraste, orientação, inclinação, ruído visual e outras características da imagem.
O objetivo é tornar os caracteres mais fáceis de distinguir do fundo.
Uma página fotografada levemente inclinada, por exemplo, pode ser corrigida antes de o reconhecimento começar.
3. As regiões com texto são identificadas
Depois da preparação, o sistema procura áreas que provavelmente contêm conteúdo escrito.
Em um documento simples, pode haver apenas alguns parágrafos.
Em materiais mais complexos, podem existir títulos, colunas, campos de formulários, números, cabeçalhos e outros elementos distribuídos pela página.
Identificar onde o texto está localizado ajuda o sistema a compreender a estrutura visual do documento antes de interpretar cada palavra.
4. Letras e palavras são reconhecidas
Essa é a etapa central do OCR.
O sistema analisa os padrões visuais e tenta determinar quais letras, números ou símbolos estão representados na imagem.
Em tecnologias mais antigas, esse processo dependia principalmente da comparação entre os caracteres encontrados e modelos previamente definidos.
Soluções atuais podem utilizar aprendizado de máquina e modelos treinados com grandes quantidades de exemplos, permitindo reconhecer variações de fontes, tamanhos, estilos e diferentes condições de captura.
Em vez de analisar somente um caractere isolado, sistemas mais avançados também podem considerar palavras, linhas e o contexto em que os caracteres aparecem.
5. O conteúdo reconhecido é organizado
Depois de identificar os caracteres, o sistema precisa reconstruir o texto em uma ordem coerente.
Isso é especialmente importante quando uma página contém vários parágrafos, colunas ou diferentes blocos de informação.
Dependendo da solução utilizada, o resultado pode ser apresentado apenas como texto simples ou pode incluir informações sobre a estrutura e posição dos elementos encontrados.
6. O texto pode ser revisado e utilizado
O conteúdo reconhecido finalmente é transformado em texto digital.
A partir desse ponto, ele pode ser selecionado, copiado, editado, pesquisado ou utilizado em outros programas.
Mesmo quando o resultado parece correto, é recomendável revisar informações importantes antes de utilizá-las, principalmente números, valores, códigos, nomes próprios e dados de documentos.
Um Exemplo Simples de OCR na Prática
Imagine que você tenha uma fotografia de um recibo contendo:
Mercado Central
Total: R$ 86,40
Data: 15/09/2026
Para você, essas informações são imediatamente compreensíveis.
Para um computador que esteja tratando o arquivo apenas como imagem, porém, não existe necessariamente a informação digital “R$ 86,40”. Existem apenas pixels formando os caracteres que visualmente representam esse valor.
O OCR analisa esses padrões e tenta reconstruir o conteúdo como texto.
Depois do reconhecimento, você pode copiar o valor para uma planilha, pesquisar a data ou armazenar o conteúdo junto com outros registros.
Qual É a Diferença Entre Digitalização e OCR?
Digitalização e OCR são conceitos relacionados, mas não significam exatamente a mesma coisa.
Digitalizar significa criar uma representação digital de um documento físico. Quando você utiliza um scanner para gerar uma imagem de uma página, por exemplo, já realizou uma digitalização.
Isso não significa necessariamente que o texto daquela página possa ser selecionado ou pesquisado.
O OCR acrescenta outra etapa: reconhecer o conteúdo escrito dentro daquela imagem e convertê-lo em informação textual.
Portanto, um documento pode estar digitalizado sem ter passado por reconhecimento óptico de caracteres.
OCR e PDF Pesquisável São a Mesma Coisa?
Não exatamente.
Um PDF pesquisável é normalmente um documento no qual as palavras podem ser localizadas por meio da ferramenta de busca.
Quando um PDF é criado diretamente por um editor de texto, geralmente já possui conteúdo textual digital.
Entretanto, muitos PDFs produzidos por scanners contêm apenas imagens das páginas. Visualmente parecem documentos normais, mas não permitem selecionar ou pesquisar as palavras.
Nesses casos, o OCR pode ser utilizado para reconhecer o conteúdo das páginas e ajudar a criar uma camada de texto pesquisável.
Esse tema merece uma explicação própria porque existem diferenças importantes entre PDFs originalmente digitais, PDFs escaneados e documentos processados com OCR.
OCR Funciona Apenas com Texto Impresso?
Não.
Algumas tecnologias modernas também conseguem reconhecer escrita manual.
Entretanto, texto manuscrito costuma representar um desafio maior porque cada pessoa possui uma forma diferente de escrever.
Letras cursivas, caracteres conectados, abreviações e caligrafia irregular podem tornar o reconhecimento mais difícil.
Por isso, a precisão com textos manuscritos pode variar bastante conforme a qualidade da imagem, a legibilidade da escrita e a tecnologia utilizada.
Textos impressos com fontes comuns, bom contraste e alta nitidez normalmente apresentam condições mais favoráveis para reconhecimento.
OCR Tradicional e OCR com Inteligência Artificial
A tecnologia OCR evoluiu significativamente.
Sistemas tradicionais dependiam bastante de regras e correspondência entre padrões visuais e modelos conhecidos de caracteres.
Hoje, muitas soluções incorporam aprendizado de máquina e técnicas de visão computacional para reconhecer textos em condições mais variadas.
Isso ajuda sistemas modernos a lidar melhor com diferentes fontes, documentos fotografados, pequenas distorções e layouts mais complexos.
Algumas soluções vão além do simples reconhecimento de palavras e tentam identificar elementos como tabelas, campos de formulários e relações entre diferentes informações da página.
Ainda assim, OCR e inteligência artificial não são termos equivalentes.
OCR descreve especificamente o processo de reconhecimento e transformação de conteúdo visual escrito em texto digital. Inteligência artificial é um conceito muito mais amplo e pode ser utilizada como uma das tecnologias envolvidas nesse processo.
Onde o OCR É Usado?
O reconhecimento óptico de caracteres aparece em muitas atividades que fazem parte do cotidiano.
Em estudos, pode ajudar a transformar páginas fotografadas, apresentações e materiais impressos em anotações digitais.
Na administração de empresas, pode ser utilizado na digitalização de contratos, formulários, relatórios e documentos antigos.
Recibos e notas fiscais podem ser processados para facilitar a organização de datas, valores e outras informações.
Bibliotecas e arquivos podem aplicar OCR a coleções digitalizadas para tornar conteúdos históricos mais fáceis de pesquisar.
Também é possível encontrar reconhecimento de texto em aplicativos móveis, scanners, serviços de armazenamento de documentos e ferramentas especializadas em processamento de imagens.
Até recursos como o Google Lens utilizam reconhecimento de texto como parte de suas funcionalidades. Se quiser entender as diferenças práticas entre essas opções, veja nosso conteúdo sobre Google Lens vs OCR Online [link interno para o comparativo].
O OCR É Sempre 100% Preciso?
Não.
Nenhum sistema de OCR deve ser tratado como infalível.
A qualidade do reconhecimento depende de vários fatores relacionados tanto à imagem original quanto à tecnologia utilizada.
Uma fotografia nítida de uma página bem iluminada é muito diferente de uma imagem borrada, inclinada e fotografada em ambiente escuro.
Caracteres semelhantes também podem causar confusão. Dependendo da fonte e da qualidade da imagem, por exemplo, o número “0” pode parecer a letra “O”, enquanto o número “1” pode ser confundido com determinados caracteres.
Por esse motivo, resultados de OCR devem ser revisados quando a informação for importante.
Isso é ainda mais relevante em documentos financeiros, jurídicos, acadêmicos ou administrativos, nos quais uma pequena alteração em um número ou palavra pode mudar completamente o significado.
O Que Pode Reduzir a Precisão do OCR?
A qualidade da imagem exerce grande influência sobre o resultado.
Texto borrado dificulta a definição dos limites dos caracteres. Uma imagem muito pequena pode não apresentar detalhes suficientes para distinguir letras parecidas. Sombras sobre a página podem reduzir o contraste, enquanto um documento fotografado em ângulo pode distorcer linhas e palavras.
Fontes muito decorativas, fundos com muitos elementos gráficos e textos excessivamente pequenos também podem representar desafios.
Documentos com várias colunas, tabelas complexas ou diferentes orientações de texto exigem ainda mais da tecnologia utilizada.
Por isso, quando possível, trabalhar com uma imagem clara, alinhada e bem iluminada tende a fornecer melhores condições para o reconhecimento.
Como Melhorar o Resultado de um OCR?
Antes de processar um documento, observe a qualidade da imagem original.
Procure fotografar ou digitalizar o material com iluminação uniforme e mantendo o texto em foco. Evite sombras, reflexos e ângulos muito inclinados.
Quando apenas uma pequena parte da fotografia contém as informações necessárias, recortar a região relevante também pode ajudar.
Depois do processamento, compare o texto extraído com o arquivo original, principalmente quando houver datas, números, nomes, códigos ou outros dados que precisam estar corretos.
Esses pequenos cuidados podem reduzir a quantidade de correções necessárias depois da conversão.
OCR Pode Reconhecer Texto de Capturas de Tela?
Sim.
Uma captura de tela continua sendo uma imagem, mesmo quando contém frases perfeitamente legíveis.
OCR pode identificar as palavras incorporadas ao print e transformá-las em conteúdo selecionável.
Isso pode ser útil quando você recebe uma captura de uma conversa, página de aplicativo, mensagem, endereço ou outro conteúdo que precisa reutilizar.
Em vez de digitar todas as informações manualmente, você pode reconhecer o texto e depois revisar apenas o resultado.
OCR Pode Extrair Texto de Fotos?
Sim.
Fotografias de livros, documentos, placas, anotações e materiais impressos podem ser processadas por OCR desde que o texto esteja suficientemente visível.
O resultado, entretanto, depende da qualidade da fotografia.
Foco, iluminação, resolução, contraste e posição da câmera podem influenciar diretamente a legibilidade dos caracteres.
Como Usar OCR para Transformar uma Imagem em Texto?
Na prática, utilizar OCR pode ser muito simples.
Você seleciona uma imagem que contenha texto, envia o arquivo para uma ferramenta compatível e aguarda o reconhecimento. Depois, revisa o resultado antes de copiar ou reutilizar o conteúdo.
Se você quer aprender esse processo detalhadamente, consulte nosso guia sobre como transformar imagem em texto [link interno para o guia passo a passo].
Você também pode experimentar diretamente a ferramenta Transformar Imagem em Texto [link interno para a homepage] quando tiver uma foto, captura de tela ou documento que precise converter.
Perguntas Frequentes Sobre OCR
O que significa OCR?
OCR significa Optical Character Recognition, ou Reconhecimento Óptico de Caracteres. É uma tecnologia utilizada para identificar texto dentro de imagens e convertê-lo em informação digital.
Para que serve o OCR?
O OCR serve principalmente para transformar palavras presentes visualmente em fotografias, documentos digitalizados e outras imagens em texto que pode ser selecionado, pesquisado, copiado e editado.
Como funciona o reconhecimento óptico de caracteres?
O sistema analisa uma imagem, identifica áreas que provavelmente contêm texto e utiliza algoritmos de reconhecimento para determinar quais caracteres, palavras e linhas aparecem no arquivo. Depois, reconstrói essas informações como texto digital.
OCR funciona em documentos digitalizados?
Sim. Esse é um dos usos mais comuns da tecnologia. Um documento pode ser digitalizado como imagem e depois processado por OCR para tornar seu conteúdo textual mais fácil de pesquisar e reutilizar.
OCR funciona com texto manuscrito?
Algumas tecnologias conseguem reconhecer escrita manual, mas a precisão pode variar bastante. Caligrafia clara e imagens de boa qualidade costumam oferecer melhores condições para o reconhecimento.
Qual é a diferença entre OCR e scanner?
O scanner cria uma cópia digital de um documento físico. O OCR analisa o conteúdo visual dessa cópia e tenta transformar os caracteres presentes nela em texto digital.
É necessário revisar o texto depois do OCR?
Sim, principalmente quando as informações são importantes. Imagens de baixa qualidade, fontes incomuns, caracteres semelhantes e layouts complexos podem provocar erros de reconhecimento.
Conclusão
OCR é a tecnologia que cria uma ponte entre informações visuais e texto digital.
Quando uma palavra está presa dentro de uma fotografia, captura de tela ou documento escaneado, o Reconhecimento Óptico de Caracteres permite identificar aquele conteúdo e transformá-lo em texto que pode ser pesquisado, editado e reutilizado.
A tecnologia tornou a digitalização de informações muito mais prática e hoje aparece em ferramentas online, aplicativos móveis, sistemas de gerenciamento de documentos e soluções empresariais.
Entretanto, o resultado não depende apenas do sistema utilizado. A qualidade da imagem, nitidez, iluminação, alinhamento e legibilidade do material também têm papel importante na precisão.
Se você possui uma fotografia ou documento com informações que precisa copiar, pode utilizar a ferramenta Transformar Imagem em Texto [link interno para a página principal] para aplicar OCR e obter uma versão editável do conteúdo.