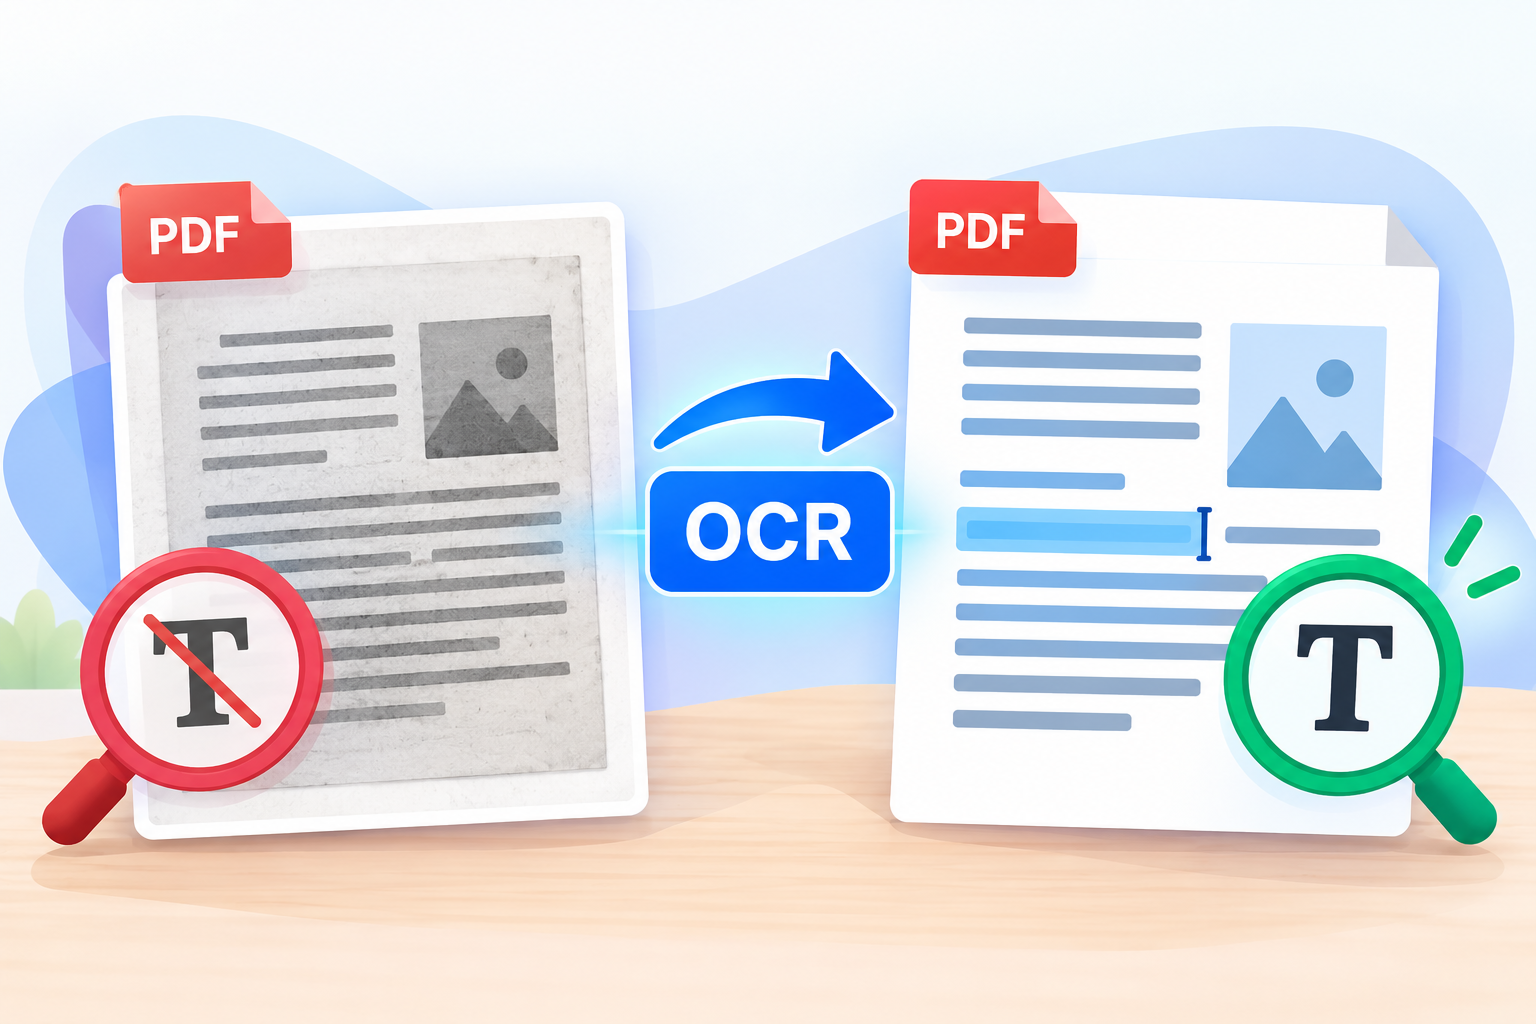
Dois arquivos podem terminar em .pdf, parecer exatamente iguais na tela e, ainda assim, funcionar de maneiras completamente diferentes.
Em um deles, você consegue selecionar uma frase, copiar um parágrafo e pesquisar uma palavra usando Ctrl + F. No outro, nada disso funciona, mesmo que o texto esteja perfeitamente visível.
A diferença normalmente está na forma como o conteúdo foi criado e armazenado.
Um PDF pesquisável contém texto que o computador consegue reconhecer e localizar. Já um PDF digitalizado pode ser composto apenas por imagens das páginas originais, sem uma camada textual associada.
É aqui que tecnologias como o OCR (Reconhecimento Óptico de Caracteres) se tornam importantes.
Neste guia, você vai entender o que é um PDF pesquisável, como ele se diferencia de um documento digitalizado, como identificar cada tipo e quando utilizar OCR para extrair ou reconhecer o conteúdo.
O Que É um PDF Pesquisável?
Um PDF pesquisável é um arquivo cujo conteúdo textual pode ser identificado pelo software utilizado para abrir o documento.
Isso significa que você pode realizar ações como:
- pesquisar uma palavra específica;
- selecionar frases;
- copiar trechos;
- localizar números ou nomes;
- utilizar parte do conteúdo em outros documentos;
- trabalhar com recursos de acessibilidade compatíveis.
Imagine um relatório de 100 páginas.
Se ele for pesquisável e você precisar encontrar todas as ocorrências da palavra “contrato”, basta utilizar a ferramenta de pesquisa do leitor de PDF.
Se o documento for apenas uma coleção de imagens, a mesma busca pode não encontrar nada, mesmo que a palavra apareça diversas vezes visualmente.
Essa é uma das principais vantagens do texto pesquisável.
O Que É um PDF Digitalizado?
Um PDF digitalizado normalmente é criado quando páginas físicas são capturadas por um scanner ou câmera e armazenadas dentro de um arquivo PDF.
Nesse caso, cada página pode funcionar essencialmente como uma fotografia.
Você consegue visualizar:
- letras;
- números;
- assinaturas;
- tabelas;
- imagens;
- carimbos;
- elementos gráficos.
Mas isso não significa que o computador entenda automaticamente quais palavras aparecem na página.
Para o software, determinadas páginas podem ser apenas imagens compostas por pixels.
É semelhante ao que acontece quando você tira uma fotografia de uma página de livro. Você consegue ler o conteúdo, mas as palavras fazem parte da própria imagem.
A documentação do Adobe Acrobat também diferencia documentos escaneados de PDFs com texto reconhecido: arquivos escaneados podem conter apenas dados de imagem até que o reconhecimento OCR seja aplicado.
PDF Digitalizado e PDF Pesquisável: Qual É a Principal Diferença?
A diferença fundamental está na presença de texto digital reconhecível.
Em um PDF pesquisável, o programa consegue identificar as palavras presentes no documento.
Em um PDF digitalizado sem OCR, pode existir apenas uma representação visual dessas palavras.
Considere este exemplo:
Você digitalizou uma fatura em papel.
Na página aparece:
Total: R$ 248,90
Visualmente, qualquer pessoa consegue identificar o valor.
Se o arquivo for apenas uma imagem, porém, pesquisar “248,90” pode não retornar nenhum resultado.
Depois que um sistema OCR reconhece o conteúdo, o valor pode passar a existir também como informação textual, permitindo pesquisa, seleção ou extração.
Comparação Rápida: PDF Pesquisável vs PDF Digitalizado
| Característica | PDF Pesquisável | PDF Digitalizado sem OCR |
| Pesquisar palavras | Sim | Geralmente não |
| Selecionar texto | Sim | Geralmente não |
| Copiar palavras | Sim | Geralmente não |
| Conteúdo visual | Sim | Sim |
| Pode vir de scanner | Sim | Sim |
| Pode utilizar OCR | Sim | Ainda não necessariamente |
| Texto reconhecido pelo computador | Sim | Não necessariamente |
| Extração de informações | Mais simples | Pode exigir OCR |
Uma observação importante: digitalizado e pesquisável não são categorias mutuamente exclusivas.
Um documento pode ser digitalizado e depois passar por OCR.
Nesse caso, ele continuará visualmente sendo uma reprodução do documento original, mas também terá uma camada textual que permite pesquisar e selecionar palavras.
Todo PDF Digitalizado É Apenas uma Imagem?
Não necessariamente.
Um documento pode começar como uma digitalização e depois ser processado com OCR.
O resultado continua contendo a aparência visual da página original, porém passa a oferecer recursos de reconhecimento textual.
Isso é muito comum em documentos antigos, contratos, arquivos administrativos, livros digitalizados e outros materiais originalmente disponíveis apenas em papel.
Portanto, a pergunta mais útil não é apenas:
“Este PDF foi digitalizado?”
Mas também:
“Existe texto reconhecível dentro deste PDF?”
Todo PDF Pesquisável Foi Processado por OCR?
Não.
Essa é outra diferença importante.
Se você criar um documento no Word, Google Docs, LibreOffice ou outro editor e exportá-lo diretamente como PDF, o texto normalmente já nasce em formato digital.
Nesse cenário, OCR não é necessário.
O reconhecimento óptico de caracteres é particularmente útil quando o conteúdo textual existe apenas visualmente, como em uma fotografia ou página escaneada.
Podemos ter, portanto, diferentes situações:
PDF criado digitalmente
O documento foi criado em um editor de texto ou sistema semelhante e depois exportado para PDF.
O conteúdo textual já está incorporado ao arquivo.
PDF escaneado sem OCR
O documento de papel foi fotografado ou digitalizado.
As páginas são essencialmente imagens.
PDF escaneado com OCR
O documento foi digitalizado e posteriormente processado por reconhecimento óptico de caracteres.
A imagem original permanece visível, mas o arquivo ganha informações textuais pesquisáveis.
Entender essas diferenças evita a ideia de que todos os PDFs funcionam da mesma maneira.
Como Saber se um PDF É Pesquisável?
Existem alguns testes simples que você pode fazer.
1. Tente selecionar uma palavra
Abra o documento e tente selecionar apenas uma palavra com o cursor.
Se conseguir marcar letras e palavras individualmente, provavelmente existe texto reconhecido no arquivo.
Se apenas uma área inteira ou a página completa for selecionada como imagem, o documento pode ser um PDF baseado em imagem.
2. Utilize a pesquisa do leitor de PDF
Abra a ferramenta de busca utilizando a função disponível no seu leitor de PDF.
Em muitos computadores, o atalho é:
Ctrl + F no Windows
Command + F no macOS
Pesquise uma palavra que apareça claramente no documento.
Se o programa conseguir encontrá-la, existe alguma forma de texto pesquisável no arquivo.
3. Tente copiar uma frase
Selecione uma pequena frase e utilize a opção copiar.
Cole o conteúdo em um editor de texto.
Se as palavras aparecerem normalmente, o PDF contém texto que pode ser extraído.
4. Observe documentos mistos
Alguns PDFs possuem páginas digitais e páginas escaneadas no mesmo arquivo.
Nesse caso, você pode conseguir pesquisar ou copiar conteúdo de determinadas páginas, mas não de outras.
Por isso, testar apenas a primeira página nem sempre é suficiente.
Por Que Não Consigo Pesquisar Palavras em Alguns PDFs?
O motivo mais comum é que o conteúdo do documento está armazenado como imagem.
Isso acontece frequentemente quando documentos de papel são escaneados diretamente para PDF sem reconhecimento de texto.
O arquivo visual pode estar perfeitamente legível para uma pessoa, mas o software não possui informações suficientes para relacionar os pixels às palavras exibidas.
Outras situações também podem dificultar a pesquisa.
Um PDF pode conter:
- páginas com texto e páginas em imagem;
- proteção ou restrições específicas;
- caracteres reconhecidos incorretamente;
- fontes ou codificações incomuns;
- resultados de OCR com erros.
Por isso, conseguir enxergar o texto não significa necessariamente conseguir pesquisá-lo.
O Que o OCR Faz em um PDF Digitalizado?
OCR significa Optical Character Recognition, ou Reconhecimento Óptico de Caracteres.
Essa tecnologia analisa o conteúdo visual de uma página e tenta identificar letras, números, palavras e outros caracteres presentes na imagem.
Depois do reconhecimento, o sistema pode associar uma representação textual ao documento.
No Acrobat, por exemplo, o OCR pode criar uma camada pesquisável no PDF digitalizado.
De forma simplificada, imagine esta sequência:
Documento em papel → digitalização → imagem dentro do PDF → OCR → texto reconhecido
A aparência visual do documento pode continuar praticamente igual.
A principal mudança acontece na forma como o conteúdo passa a ser interpretado pelo computador.
Se quiser entender essa tecnologia com mais detalhes, consulte nosso conteúdo sobre [O Que É OCR? Como Funciona o Reconhecimento Óptico de Caracteres — link interno quando publicado].
Um PDF Pesquisável Também É Editável?
Nem sempre.
Esses dois conceitos costumam ser confundidos.
Pesquisável significa que o software consegue localizar o texto.
Selecionável significa que você consegue marcar caracteres ou palavras.
Editável significa que você consegue alterar efetivamente o conteúdo do documento.
Um PDF pode permitir busca e seleção sem funcionar como um documento do Word, no qual qualquer parágrafo pode ser modificado facilmente.
Isso depende de como o PDF foi criado, do software utilizado e da estrutura interna do arquivo.
Portanto, tornar um PDF pesquisável não significa automaticamente transformá-lo em um documento totalmente editável.
PDF Pesquisável e Texto Extraído Também São Coisas Diferentes
Outra distinção importante está entre tornar o PDF pesquisável e extrair o texto do PDF.
Ao criar um PDF pesquisável, o objetivo geralmente é manter o documento e adicionar a possibilidade de localizar seu conteúdo.
Ao extrair o texto, o objetivo é obter as palavras separadamente para copiá-las, editá-las ou utilizá-las em outro lugar.
Por exemplo, você pode ter uma página digitalizada contendo um contrato.
Uma opção é aplicar OCR e manter o contrato como PDF pesquisável.
Outra é utilizar uma ferramenta para [transformar imagem em texto — link para a ferramenta principal] e trabalhar apenas com o conteúdo reconhecido.
A escolha depende do que você pretende fazer depois.
Quando É Melhor Usar um PDF Pesquisável?
O formato pesquisável é particularmente útil quando você deseja manter a aparência e a estrutura do documento original.
Alguns exemplos incluem:
Arquivos com muitas páginas
Pesquisar palavras em relatórios, livros, contratos ou documentos administrativos pode economizar bastante tempo.
Documentos arquivados
Uma coleção de documentos antigos se torna mais fácil de consultar quando as páginas possuem texto pesquisável.
Trabalhos acadêmicos
Encontrar rapidamente um termo dentro de dezenas ou centenas de páginas facilita a consulta de materiais digitalizados.
Documentos empresariais
Relatórios, contratos, formulários e registros históricos podem ser mais fáceis de organizar e consultar quando o conteúdo textual é reconhecido.
Materiais de referência
Manuais, catálogos e documentos técnicos podem se tornar mais práticos quando o usuário consegue pesquisar informações específicas.
Quando É Melhor Extrair o Texto em Vez de Criar um PDF Pesquisável?
Nem sempre você precisa preservar o documento completo.
Às vezes, o objetivo é simplesmente obter o conteúdo que aparece dentro dele.
Imagine que você tenha uma página escaneada contendo uma lista de informações que precisa colocar em outro documento.
Nesse caso, pode ser mais prático extrair o texto do que reconstruir todo o PDF.
A ferramenta do TransformarImagemEmTexto.com aceita arquivos PDF compatíveis e pode analisar conteúdo textual presente em páginas digitalizadas.
Isso pode ser útil quando você deseja:
- copiar parágrafos;
- recuperar informações de um documento;
- reutilizar anotações;
- extrair dados de uma página;
- trabalhar com texto fora do PDF.
Para entender o processo, consulte também [Como Transformar Imagem em Texto: Guia Passo a Passo — link interno].
Um PDF Digitalizado Pode Ter Boa Qualidade e Mesmo Assim Não Ser Pesquisável?
Sim.
Qualidade visual e capacidade de pesquisa são características diferentes.
Um scanner pode produzir uma reprodução extremamente nítida de um documento.
Ainda assim, se o arquivo contiver apenas imagens e nenhum processo de reconhecimento textual tiver sido aplicado, uma pesquisa por palavras pode não funcionar.
Da mesma forma, um PDF visualmente imperfeito pode ter passado por OCR e permitir buscas.
Por isso, não é possível determinar com segurança se um documento é pesquisável apenas observando sua qualidade visual.
A Qualidade da Digitalização Afeta o OCR?
Sim.
Como o OCR precisa interpretar visualmente os caracteres, a qualidade da página pode influenciar o reconhecimento.
Problemas comuns incluem:
- texto borrado;
- baixa resolução;
- páginas inclinadas;
- sombras;
- reflexos;
- pouco contraste;
- manchas;
- fontes muito pequenas;
- caracteres parcialmente apagados;
- páginas dobradas.
Quanto mais fácil for para uma pessoa distinguir as letras, melhores costumam ser as condições para o reconhecimento automático.
Isso não significa que uma imagem perfeita sempre produzirá um resultado sem erros, mas uma digitalização clara tende a facilitar o processo.
OCR Pode Cometer Erros em PDFs?
Sim.
OCR não deve ser considerado infalível.
Alguns caracteres possuem formas visualmente semelhantes.
Por exemplo:
- O e 0;
- I, l e 1;
- S e 5.
Documentos antigos, páginas danificadas, fontes incomuns ou fotografias de baixa qualidade podem aumentar esse tipo de problema.
Por essa razão, informações importantes devem ser revisadas depois do reconhecimento.
A própria documentação do Acrobat recomenda revisar os resultados após o OCR e corrigir eventuais erros de reconhecimento.
Essa revisão é especialmente importante em:
- valores financeiros;
- datas;
- números de documentos;
- códigos;
- nomes próprios;
- informações acadêmicas;
- documentos administrativos ou jurídicos.
PDF Pesquisável Ajuda na Organização de Documentos?
Sim.
Imagine uma pasta contendo centenas de documentos escaneados.
Se todos forem apenas imagens, encontrar uma informação específica pode exigir abrir vários arquivos e ler as páginas manualmente.
Quando o conteúdo é reconhecido, ferramentas compatíveis podem localizar palavras dentro dos documentos com muito mais facilidade.
Isso transforma uma coleção de páginas digitalizadas em um conjunto de informações mais simples de consultar.
É uma vantagem particularmente relevante para empresas, estudantes, pesquisadores e pessoas que mantêm grandes arquivos digitais.
PDF Pesquisável É Melhor que PDF Digitalizado?
Não se trata exatamente de escolher um ou outro.
Um PDF pesquisável pode ser justamente um PDF digitalizado que passou por OCR.
A digitalização preserva uma representação visual do documento físico.
O OCR adiciona a possibilidade de interpretar o texto presente nessa representação.
Em muitos casos, as duas tecnologias são complementares:
Digitalização preserva a página.
OCR ajuda o computador a entender o texto.
Portanto, quando você precisa consultar o conteúdo posteriormente, um documento digitalizado com texto pesquisável tende a ser mais funcional do que uma simples imagem das páginas.
Google Lens Também Reconhece Texto de Documentos?
Sim, ferramentas como Google Lens podem identificar texto presente em imagens e permitir diferentes ações sobre o conteúdo reconhecido.
Mas o objetivo e a forma de uso podem ser diferentes de uma ferramenta focada em conversão ou extração de texto.
Como Transformar um PDF Digitalizado em Conteúdo Pesquisável?
Em linhas gerais, o processo envolve quatro etapas:
- abrir ou enviar o documento;
- aplicar uma ferramenta de OCR;
- aguardar o reconhecimento das páginas;
- revisar o texto identificado.
Alguns programas adicionam uma camada de texto ao próprio PDF.
Outras ferramentas extraem o conteúdo e apresentam o resultado separadamente.
A opção ideal depende do objetivo.
Se você deseja continuar trabalhando com o arquivo em formato PDF, procure uma ferramenta capaz de criar uma camada pesquisável.
Se deseja principalmente copiar o conteúdo do documento, uma ferramenta de extração de texto pode ser mais direta.
Como Extrair Texto de um PDF Digitalizado?
Se o PDF funciona como uma imagem, uma das alternativas é utilizar OCR para analisar as páginas.
No [Transformar Imagem em Texto — link para a ferramenta principal], arquivos PDF estão entre os formatos compatíveis atualmente informados pela ferramenta.
O fluxo é simples:
- selecione o PDF;
- envie o arquivo;
- inicie o reconhecimento;
- aguarde o processamento;
- revise o conteúdo extraído;
- copie ou baixe o texto conforme necessário.
Se o documento contiver informações importantes, compare sempre o resultado com a página original antes de utilizá-lo.
Perguntas Frequentes Sobre PDF Pesquisável
O que significa PDF pesquisável?
É um PDF cujo conteúdo textual pode ser localizado por ferramentas de busca dentro do documento. Dependendo de sua estrutura, também pode permitir selecionar e copiar as palavras.
Qual é a diferença entre um PDF normal e um PDF pesquisável?
Muitos PDFs criados digitalmente já são pesquisáveis. O problema aparece principalmente em documentos formados apenas por imagens digitalizadas, nos quais o texto pode não estar disponível para busca.
PDF digitalizado é uma imagem?
Em muitos casos, sim. Cada página pode ser armazenada como uma imagem dentro do arquivo PDF. Porém, um PDF digitalizado também pode passar por OCR e ganhar uma camada textual.
Como saber se meu PDF foi digitalizado?
Tente selecionar palavras individuais e pesquisar uma frase que apareça na página. Se o documento se comportar apenas como uma imagem, provavelmente não possui texto digital reconhecido naquela área.
Por que o Ctrl + F não encontra palavras no meu PDF?
Uma possível razão é que as páginas estejam armazenadas somente como imagens. Nesse caso, o software consegue exibir visualmente as palavras, mas não possui texto pesquisável associado a elas.
O que é OCR em PDF?
OCR em PDF é o uso de reconhecimento óptico de caracteres para identificar palavras presentes em páginas ou imagens e convertê-las em informações textuais que podem ser pesquisadas ou extraídas.
Um PDF pesquisável pode ter sido escaneado?
Sim. Um documento pode ser escaneado e posteriormente processado com OCR, mantendo a imagem original da página e adicionando texto reconhecido.
Posso copiar texto de um PDF digitalizado?
Se o arquivo não possuir uma camada textual, talvez não seja possível copiar as palavras diretamente. Nesse caso, uma ferramenta OCR pode ajudar a reconhecer e extrair o conteúdo.
OCR altera a aparência do PDF?
Depende da ferramenta e do método utilizado. Algumas soluções preservam a imagem original e adicionam uma camada textual pesquisável. Outras podem reconstruir partes do documento.
PDF pesquisável é o mesmo que PDF editável?
Não. Um documento pesquisável permite localizar texto, mas isso não significa necessariamente que todo o conteúdo possa ser alterado livremente.
Conclusão
A diferença entre PDF pesquisável e PDF digitalizado está principalmente na forma como o computador interpreta o conteúdo.
Um PDF digitalizado pode simplesmente armazenar imagens das páginas de um documento físico. Nesse caso, você consegue visualizar as palavras, mas talvez não consiga pesquisá-las, selecioná-las ou copiá-las.
Um PDF pesquisável contém informações textuais que podem ser reconhecidas pelo software.
Quando um documento existe apenas como imagem, o OCR pode atuar como ponte entre esses dois formatos, identificando os caracteres da página e transformando informações visuais em texto digital.
Isso torna documentos digitalizados muito mais úteis para pesquisas, arquivos, estudos, organização e recuperação de informações.
Se o seu objetivo não for manter um PDF pesquisável, mas simplesmente recuperar as palavras presentes em uma página, você também pode utilizá-lo para extrair conteúdo de arquivos compatíveis e trabalhar diretamente com o texto reconhecido.